
“예시를 몇 개 넣어라”는 조언은 많습니다. 그런데 예시 하나가 몇 토큰인지는 아무도 알려주지 않습니다. 예시는 시스템 프롬프트에 들어가니 매 호출마다 전액 다시 전송됩니다.
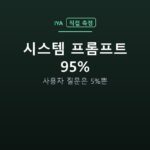
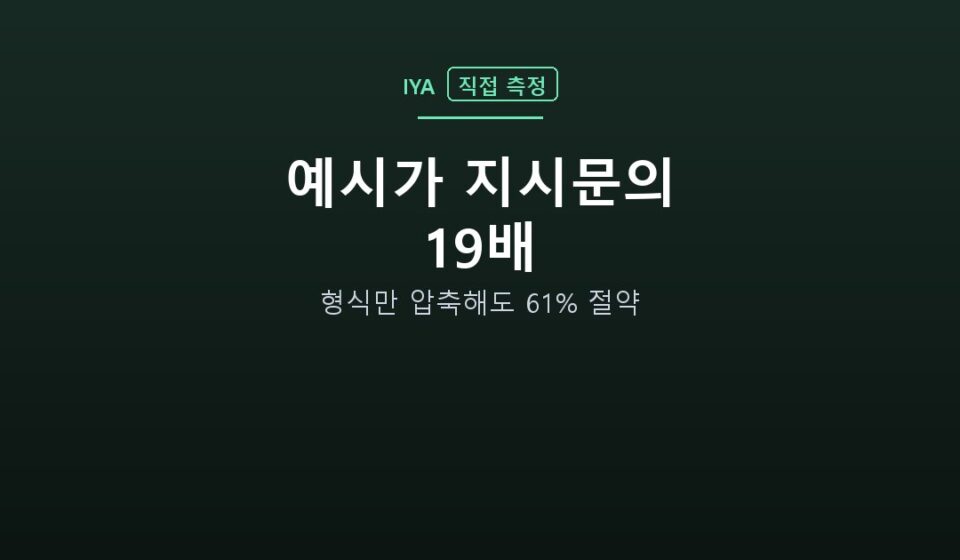
재봤습니다. 예시 5개를 자세히 쓰면 지시문의 19배가 됩니다. 지시문 12토큰에 예시 219토큰이 붙어서, 전체의 95%가 예시입니다.
측정 조건
- 인코딩
o200k_base·tiktoken 0.14.0· 측정일 2026년 10월 13일 - 과제: 고객 문의를 읽고 담당 부서를 분류 (지시문 12토큰)
- 같은 예시 5개를 자세히 / 보통 / 압축 세 가지 형식으로 작성
- 표본은 전부 직접 작성
세 형식은 이렇게 다릅니다.
[자세히 — 평균 43.8토큰]
문의: "결제했는데 주문 내역에 안 보여요."
담당 부서: 결제팀
이유: 결제는 됐으나 주문이 생성되지 않은 건으로 결제팀이 확인해야 합니다.

[보통 — 평균 23.0토큰]
문의: "결제했는데 주문 내역에 안 보여요."
담당 부서: 결제팀

[압축 — 평균 15.0토큰]
결제했는데 주문 내역에 안 보여요 → 결제팀
예시 1개가 몇 토큰인가
| 형식 | 평균 | 최소 | 최대 |
|---|---|---|---|
| 자세히 (이유까지 씀) | 43.8 | 35 | 52 |
| 보통 (입력·출력만) | 23.0 | 19 | 26 |
| 압축 (화살표) | 15.0 | 11 | 18 |
같은 내용인데 형식만으로 2.9배 차이가 납니다. ‘이유’를 덧붙이는 습관이 예시당 20토큰을 더 씁니다.
예시를 늘리면 이렇게 쌓인다
지시문 12토큰에 예시를 하나씩 더해 봤습니다.
| 예시 수 | 자세히 | 보통 | 압축 |
|---|---|---|---|
| 0개 (지시문만) | 12 | 12 | 12 |
| 1개 | 61 | 35 | 27 |
| 2개 | 113 | 60 | 44 |
| 3개 | 155 | 87 | 63 |
| 5개 | 231 | 131 | 91 |
예시 5개를 자세히 쓰면 231토큰 — 지시문의 19.2배입니다. 전체의 95%가 예시이고, 정작 시키는 일은 5%입니다.
압축 형식으로 쓰면 91토큰, 61% 절약됩니다.
| 호출 수 | 자세히 5개 | 압축 5개 | 차이 |
|---|---|---|---|
| 1,000회 | 231,000 | 91,000 | 140,000 |
| 10,000회 | 2,310,000 | 910,000 | 1,400,000 |
| 100,000회 | 23,100,000 | 9,100,000 | 14,000,000 |
예시 대신 규칙 한 줄로 쓰면?
예시 5개가 알려주려던 걸 규칙 한 줄로 바꿔 써 봤습니다.
부서 기준: 결제 오류→결제팀 / 상품 불만족→반품팀 /
계정·로그인→기술지원팀 / 주문 변경·취소→주문팀 / 증빙 서류→회계팀| 방식 | 토큰 | 10,000회 누적 |
|---|---|---|
| 지시문만 (예시 없음) | 12 | 120,000 |
| 규칙 한 줄 | 62 | 620,000 |
| 압축 예시 5개 | 91 | 910,000 |
| 보통 예시 5개 | 131 | 1,310,000 |
| 자세한 예시 5개 | 231 | 2,310,000 |
규칙 방식이 압축 예시보다 29토큰, 자세한 예시보다 169토큰 싸습니다.
⚠️ 그런데 여기서 멈추면 안 됩니다
저는 토큰만 쟀습니다. 분류가 얼마나 정확한지는 재지 않았습니다. 이건 이 측정의 가장 큰 한계이고, 결론을 뒤집을 수 있는 부분입니다.
few-shot 예시를 쓰는 이유는 원래 규칙보다 잘 먹히기 때문입니다. 말로 설명하기 어려운 판단 기준을 예시가 대신 보여줍니다. 싸다고 규칙으로 바꿨다가 정확도가 떨어지면, 재질문과 사람 손이 늘어 토큰으로 아낀 것보다 더 비싸집니다.
그래서 이 측정은 “예시를 빼라”는 뜻이 아닙니다. 이렇게 쓰시면 됩니다.
- 형식부터 압축하세요. 예시 개수를 줄이는 것보다 안전합니다 — 보여주는 사례 수는 그대로 두고 61%를 아낍니다. 여기엔 정확도 위험이 거의 없습니다.
- ‘이유’ 설명은 빼보세요. 예시당 20토큰인데, 모델이 꼭 필요로 하는지 확인해 볼 만합니다.
- 개수를 줄이거나 규칙으로 바꾸는 건 반드시 정확도를 같이 재면서 하세요. 같은 입력 20~30건을 양쪽에 넣어 결과를 비교하면 됩니다.
- 호출이 적으면 그냥 자세히 쓰세요. 1,000회면 23만 토큰이라 큰돈이 아닙니다.
직접 재보기
본인 예시가 몇 토큰인지는 토큰 계산기에 붙여 넣으면 바로 나옵니다. 예상 호출 수를 곱해 보세요.
import tiktoken
enc = tiktoken.get_encoding("o200k_base")
n = lambda t: len(enc.encode(t))

instr = "고객 문의를 읽고 담당 부서를 정하세요."
examples = [
    "결제했는데 주문 내역에 안 보여요 → 결제팀",
    "받은 옷이 사진과 색이 달라요 → 반품팀",
    # ... 실제 쓰는 예시를 넣으세요
]

for k in (0, 1, 2, 3, 5):
    total = n(instr) + (n("\n".join(examples[:k])) if k else 0)
    print("예시 %d개: %d토큰 (1만 회면 %s)"
          % (k, total, format(total * 10000, ",")))
한계: 토큰만 측정했고 분류 정확도는 측정하지 않았습니다(위에서 적은 그대로입니다). 과제는 부서 분류 한 가지이고 예시도 5개뿐이라, 다른 과제에서는 예시 길이와 비중이 다를 수 있습니다. 프롬프트 캐싱을 지원하는 서비스에서는 반복 비용이 크게 줄어 이 계산이 그대로 적용되지 않습니다. 출력 토큰은 포함하지 않았습니다.
정리
- 예시 1개는 압축 15토큰 / 보통 23토큰 / 자세히 44토큰 — 형식만으로 2.9배.
- 예시 5개를 자세히 쓰면 231토큰, 지시문의 19.2배, 전체의 95%.
- 형식 압축만으로 61% 절약 — 사례 수를 줄이지 않아 가장 안전한 방법.
- 규칙 한 줄(62토큰)이 압축 예시 5개(91토큰)보다 싸다.
- 단, 토큰만 쟀습니다. 정확도가 떨어지면 아낀 것보다 더 비싸집니다.
- 형식은 바로 압축하고, 개수·방식 변경은 정확도를 재면서 하세요.
측정일: 2026년 10월 13일 / tiktoken 0.14.0 / o200k_base / 입력 토큰 기준
이어서 읽기