
“한국어는 글자 수 × 0.58쯤이 토큰이다” — 저희도 이렇게 써 왔습니다. 그런데 그 추정이 실제로 얼마나 맞는지는 재본 적이 없었습니다. 이번에 재봤습니다.
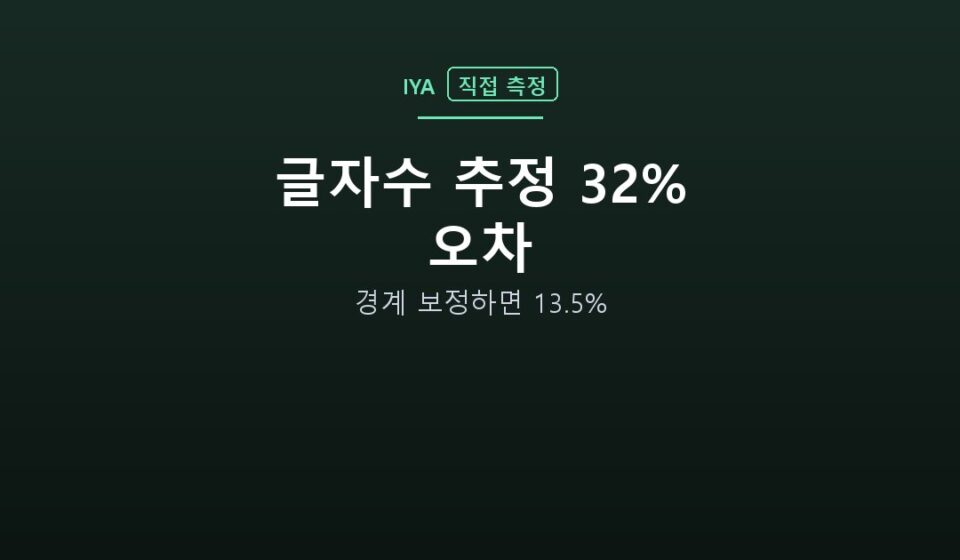
결론부터 말하면 생각보다 많이 틀립니다. 그리고 더 정교한 식을 만들어도 한계가 분명했습니다.
측정 조건
- 인코딩
o200k_base·tiktoken 0.14.0· 측정일 2026년 10월 12일 - 표본 30개 — 업무 메일, 코드, SQL, 계약 조항, 카톡체, 이모지, 한자 혼용, 주소, 숫자 표 등 장르를 섞음. 전부 직접 작성
- 학습 18개 / 검증 12개로 나눠 적합. 아래 수치는 검증셋(처음 보는 문서) 기준
학습셋에서만 잰 오차는 의미가 없어서 반드시 나눴습니다. 실제로 같은 식이 학습셋에서는 8.1%, 검증셋에서는 13.5%로 벌어졌습니다.
결론부터
| 추정 방식 | 검증셋 평균 오차 | 최악의 문서 |
|---|---|---|
| 글자 수 × 0.587 (단일 계수) | 32.6% | 104.2% |
| 문자 종류별 계수 + 경계 보정 | 13.5% | 31.6% |
| 토크나이저로 직접 세기 | 0% | 0% |
단일 계수는 문서에 따라 두 배까지 틀립니다. 영문·숫자·코드가 섞이면 걷잡을 수 없습니다.
왜 단일 계수가 이렇게 틀리는가
문자 종류마다 토큰 소모율이 크게 다르기 때문입니다. 종류별로 따로 재보면 이렇습니다.
| 문자 종류 | 글자당 토큰 | 메모 |
|---|---|---|
| 영문 | 0.231 | 가장 효율적. 흔한 단어는 통째로 1토큰 |
| 공백 | 0.390 | 대개 앞 낱말에 흡수됨 |
| 기호 | 0.580 | — |
| 한글 | 0.635 | — |
| 한자 | 0.653 | — |
| 숫자 | 0.683 | 자릿수마다 쪼개지는 경우가 많음 |
| 이모지 | 0.948 | 하나에 1토큰에 가까움 |
영문 0.231과 이모지 0.948은 네 배 차이입니다. 그러니 “글자 수 × 하나의 숫자”로는 애초에 맞출 수가 없습니다.
그런데 종류별로 나눠도 안 맞았습니다
처음엔 종류별 계수를 각각 따로 재서 단순히 더해봤습니다. 결과는 오히려 더 나빴습니다 — 평균 32.7%로 단일 계수와 비슷했고, 전부 실제보다 적게 나왔습니다.
빠진 것이 있었습니다. 문자 종류가 바뀌는 지점에서 추가 비용이 듭니다.
2026년처럼 숫자와 한글이 붙으면 토크나이저는 그 경계에서 조각을 끊습니다. status, data처럼 영문이 이어질 때는 안 끊기던 것이, 종류가 바뀌면 끊깁니다. 이 경계 비용을 항으로 넣자 검증 오차가 32.6%에서 13.5%로 내려갔습니다.
적합된 경계 비용은 전환 1회당 0.170토큰이었습니다. 한국어 문서는 조사·숫자·영문이 끊임없이 섞이므로 이 항이 꽤 큽니다.
그래서 13.5%면 쓸 만한가
용도에 따라 다릅니다.
| 상황 | 추정으로 충분한가 |
|---|---|
| 이 문서가 컨텍스트 창에 들어갈까 대략 보기 | 충분 |
| 월 예산을 어림잡기 | 대체로 충분 (문서가 많으면 오차가 상쇄됨) |
| 건당 단가를 계산해 고객에게 청구 | 부족 |
| 컨텍스트 한도에 아슬아슬하게 맞추기 | 위험 (최악 31% 오차) |
특히 마지막이 문제입니다. 추정으로 “128K에 딱 맞겠네” 했다가 실제로는 넘쳐서 잘려 들어가는 경우가 생깁니다. 한도 근처에서는 반드시 실제로 세야 합니다.
그래서 계산기를 만들었습니다
글을 붙여 넣으면 추정이 아니라 실제 토크나이저로 세어 줍니다. 브라우저에서 o200k_base 토크나이저를 직접 돌리기 때문에 입력한 글은 어디로도 전송되지 않습니다.
- 같은 문장 16개를 파이썬
tiktoken 0.14.0과 대조해 16개 전부 일치 확인 - 컨텍스트 창 사용률, 대화 턴 수에 따른 누적 토큰도 함께 표시
- 단가는 수시로 바뀌므로 고정값을 넣지 않았습니다 — 쓰시는 서비스 요금을 직접 입력하시면 됩니다
라이브러리가 로드되기 전 잠깐은 위에서 만든 추정식으로 보여주고, 로드되면 정확값으로 바뀝니다. 화면의 배지가 지금 어느 쪽인지 알려줍니다. 추정과 실제가 얼마나 다른지 직접 보실 수 있습니다.
재현 코드
import re, statistics, tiktoken
enc = tiktoken.get_encoding("o200k_base")
n = lambda t: len(enc.encode(t))

def cls(ch):
    o = ord(ch)
    if ch.isspace(): return "s"
    if 0xAC00 <= o <= 0xD7A3: return "k"   # 한글
    if 0x4E00 <= o <= 0x9FFF: return "h"   # 한자
    if o >= 0x1F000:          return "e"   # 이모지
    if ch.isdigit():          return "d"
    if "a" <= ch.lower() <= "z": return "a"
    return "p"

W = {"k":0.635,"a":0.231,"d":0.683,"p":0.580,"s":0.390,"h":0.653,"e":0.948}
TR = 0.170

def estimate(t):
    s = sum(W[cls(c)] for c in t)
    prev, tr = None, 0
    for c in map(cls, t):
        if prev and c != prev and "s" not in (c, prev): tr += 1
        prev = c
    return s + TR * tr

doc = open("문서.txt", encoding="utf-8").read()
print("실측", n(doc), "/ 추정", round(estimate(doc)),
      "/ 오차 %.1f%%" % ((estimate(doc) - n(doc)) / n(doc) * 100))
한계: 표본 30개는 통계적으로 넉넉한 규모가 아닙니다. 계수는 저희가 만든 표본에 적합된 값이라 다른 장르에서는 달라질 수 있습니다. 특히 코드나 로그처럼 한 종류가 길게 이어지는 문서는 경계 항이 과대평가될 수 있습니다. 이 글의 요지는 계수 자체가 아니라 '추정에는 이 정도 한계가 있으니, 중요하면 직접 세라'는 것입니다. 또 모든 수치는 o200k_base 기준이며 구세대 cl100k_base에서는 전혀 다릅니다.
정리
- 글자 수 × 단일 계수는 처음 보는 문서에서 평균 32.6% 틀렸습니다. 최악은 두 배였습니다.
- 문자 종류별 소모율은 영문 0.231 ~ 이모지 0.948로 네 배 차이입니다.
- 종류별로 나누기만 해서는 안 됩니다. 종류가 바뀌는 경계에서 드는 비용을 빠뜨리면 오히려 더 틀립니다.
- 경계 항을 넣어 13.5%까지 줄였지만, 한도 근처 계산에는 여전히 부족합니다.
- 정확히 알아야 하면 토크나이저를 직접 돌리세요. 그러라고 계산기를 만들었습니다.
측정일: 2026년 10월 12일 / tiktoken 0.14.0 / o200k_base / 표본 30개(학습 18·검증 12), 전부 직접 작성
이어서 읽기